001 / 开发手记
关于语雀文档的处理
我抓取了 2,802 篇语雀文档。显然,我不可能一篇篇看完,所以想先做归类和总结,再把它们整理成自己的数据库。
先把文档收集起来
获取文档这一步,已经有不少现成的经验和工具可以参考,我就不重复造轮子了。文档收集下来以后,真正的问题变成了:怎么从这么多内容里找到我需要的东西?
关键词搜索,还不太够
举个例子,我想知道如何从微信中获取聊天记录,以及有哪些开源项目值得参考。只搜“微信”,结果太多;搜“微信聊天记录”,结果又太少。
我想到两个办法。一个是多关键词搜索,但还没想好具体怎么实践;另一个是向量化,用语义搜索帮我找到表达不同、意思相近的内容。
不过,向量化也不是处处都好用。搜索特定参数或函数名时,它可能还不如直接搜关键词。
服务器与 Mac 之间的往返
数据库部署在我的服务器上,但服务器配置太低,跑不动我需要的向量化处理。于是,我采用了一个挺麻烦的办法:
- 服务器实时采集文档。
- 把文档传到 Mac,在本地完成向量化。
- 再把处理结果传回服务器。
这个流程让我觉得不够方便,也限制了我随时随地只用手机完成这些操作。目前,我还没想到更合适的办法。
接入 LLM,也得控制范围
然后,我接入了 LLM,希望它能帮我更轻松地理解和整理这些文档。
但直接把整个数据库提交给模型,实在太烧 Token 了。所以,我按照语雀原有的分类把内容拆开,也借此缩小每次处理的范围。
还没做的:重要性分类
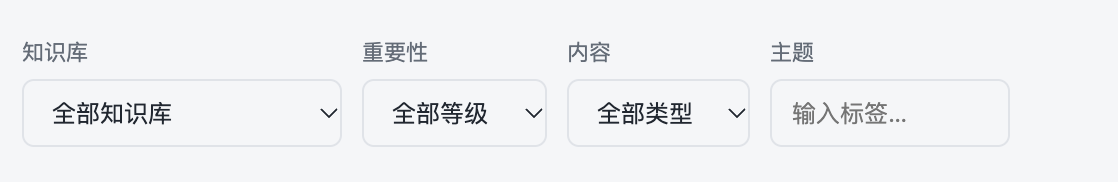
还有一个功能,我已经占好位置,但还没有做:重要性分类。
我希望这个项目最后能和个人工作台连接,有选择地推荐我需要、觉得重要或感兴趣的内容,而不是把所有文档更新一股脑地推送给我。
具体怎么实现,我还没有想好。目前有两个想法:
- 先推送一周的全部文档,由我逐条标记,看看能不能从这些反馈中整理出偏好。
- 让长期使用的 Agent 导出它对我的聊天记忆,再尝试把这些信息用于语义搜索和关键词检索。
这些都还是接下来想尝试的方向。